实现端到端模型的语音克隆方法,仅需要20秒音频就可以学习到目标说话人的说话声音和说话方式,并根据制定内容合成与该说话人相似度高的克隆语音。该方法通过引入基于梅尔频谱的风格编码器,并采用风格一致性约束策略,有效地提升了合成语音的自然度和与目标说话人的相似度。同时在音色和韵律进行解耦处理,通过结合全局音色编码器和局部韵律预测技术,实现了对语音音色和韵律的精确控制,生成具有个性化特征、真假难辨的音频。
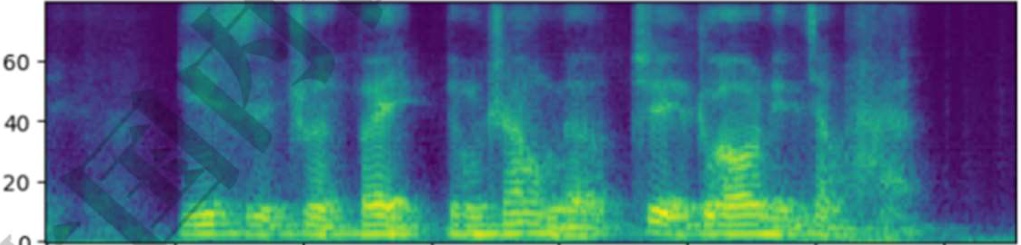
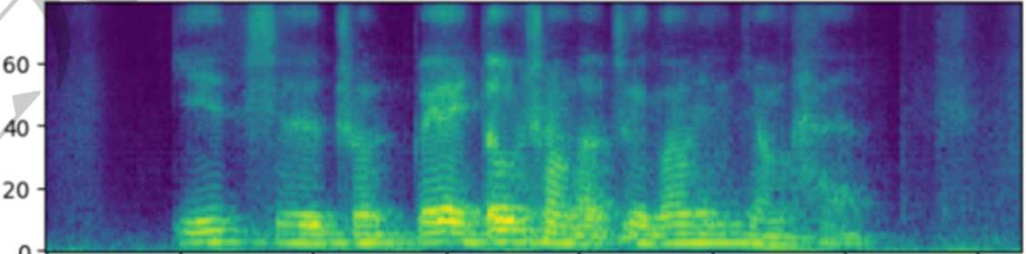
个性化语音合成技术具有广阔的应用前景。从娱乐产业中的虚拟角色配音,到教育领域的个性化语音教材,再到为视障人士提供的定制化语音助手,这项技术的应用范围极为广泛。此外,它在智能客服、有声读物制作、以及社交媒体中的个性化声音分享等方面同样具有巨大的潜力。随着技术的进步和市场的扩展,个性化语音合成技术有望进一步渗透到人机交互的各个层面,为用户提供更加丰富、自然和个性化的语音交互体验。生成音频(下)与参考音频(上)的频谱对比
面议(具体合作方式与投资规模可联系洽谈)
平均意见得分(MOS):3.93(±0.11),相似度平均意见得分(SMOS):3.88(±0.12)。
超高强镁合金及其制备成形技术

技术茂

 登录
 免费发布信息