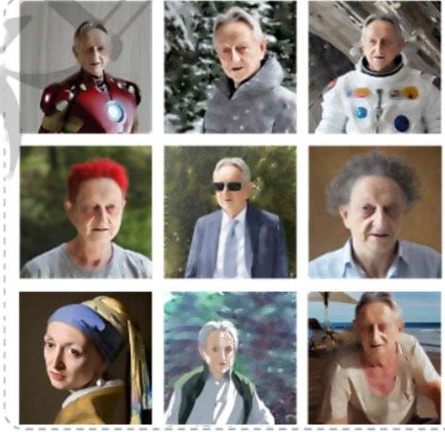
该项创新成果通过融合自然语言处理领域的知识,开发有效视频及三维内容的预训练生成模型,实现在极少数或单一图像样本的条件下,从广泛视觉内容生成转向特定视觉元素的个性化视觉内容生成,建立了一套数实融合智能分析方法体系。
该项创新成果有望重塑本省数字内容的生产流程与交互方式,为互联网和元宇宙等前沿领域提供全新的基础架构和增强生产力工具。此外,这种融合语言描述和知识库的可控视觉内容生成技术,将在教育、媒体创意产业、自动驾驶、工业制造等多个领域发挥关键作用,提升信息呈现的质量和效率,激活并推动相关应用领域的知识边界向前延伸。
面议(具体合作方式与投资规模可联系洽谈)
在3D生成模型方面优于OpenAI的ShapeE和谷歌的Dreamfusion的性能;视频生成模型优于腾讯Tuna-a-Video的性能;定制化生成取得与谷歌的DreamBooth和CMU的Custom Diffusion相当的性能,伪词生成速度提升100倍以上;在零样本图像分类和零样本指代分割任务上分别优于OpenAI的CLIP和谷歌的Global-Local CLIP的性能。
超高强镁合金及其制备成形技术

技术茂

 登录
 免费发布信息